 古老と生成AI
B107|AI同士の伝言ゲーム:最先端AIは「耳」が良くても「脳」がバグる
1. 事件発生:CER 93.36%という絶望
最初に出た数字は、93.36% だった。
CER(Character Error Rate)、文字エラー率である。100文字あれば、93文字以上が違っているという意味になる。
さすがに老生も目を疑った。
「AI音声認識、ここまで壊滅的やったんか……?」
音声合成AI(NotebookLM)が生成した会話音声を、高精度で知られる音声認識AI(Whisper)に文字起こしさせた結果がこれである。ほぼ原型をとどめていないレベルの壊滅状態に見えた。
だが、しばらく検証を重ねて気づいた。 壊れていたのはAIの耳ではない。壊れていたのは、老生の検証設計の方だったのだ。
2. 検証設計の罠:NotebookLMは「朗読」しない
なぜ93.36%なんていう大事故が起きたのか。理由は至極単純だった。
NotebookLMは、与えられた元の台本テキストをそのまま音読していたわけではなかった。文脈を咀嚼し、要約し、対話形式に再構成し、さらには「えーっと」「はい」といったリアルな相槌やアドリブまで挟んで喋っていたのだ。
それを、人間側が「元の台本」と一文字単位で機械的に比較すれば、アドリブや表現の変更がすべて大量の不一致エラー(ペナルティ)としてカウントされ、数値が大爆発するのは当然である。
これは音声認識の失敗ではない。AI同士の伝言ゲームに対し、人間側が間違った採点表を当てはめてしまった事件 だったのだ。
3. 正しいCERの作り方:真の「解答用紙」を錬成する
そこで検証モデルを一から作り直した。
- Whisperの文字起こし生データ を取得する(NotebookLMのアドリブや相槌がそのまま入ったテキスト)。
- そのテキストをベースに、人間(老生)の耳と目で「AIの純粋な聞き間違い・誤変換」だけを丁寧に手動修正し、「真の正解テキスト(Reference)」 を錬成する。
- この「真の正解テキスト」と各文字起こしデータを比較し、Levenshtein距離(編集距離)で純粋な発音エラー率(CER)を算出する。
 [ NotebookLMの音声 ]
        │
        ▼
 [ Whisper文字起こし生データ ]
        │
        ├─▶(人間が空耳・誤変換のみを修正)─▶ 【真の正解テキスト (Reference)】
        │                                             │
        └────────  **note** Levenshtein距離判定 ────────┴─▶ 【真のCER算出】
note: レーベンシュタイン距離(編集距離)とは、2つの文字列がどれくらい違うかを測る尺度であり、挿入、削除、置換の3つの操作の最小回数で判定します。
4. 判明した真のエラー率:CER 0.21%〜4.57%
検証モデルを正常化して弾き出した、4つの音声サンプルにおける真のCER(文字エラー率)がこちらである。
| サンプル名 | 純粋CER (%) | 特徴とエラーの傾向 |
|---|---|---|
| 日産アリア編 | 1.40% | 相槌やアドリブ(約2,000文字分)を除外すると極めて高精度。 |
| 量子AIの漢字グリッチ編 | 0.21% | ほぼ完璧な聴力。しかし、わずか0.21%の中に哲学的ハルシネーションが発生。 |
| 70代テクノロジーハック編 (kanwa) | 4.57% | IT専門用語、同音異義語、感情豊かな口語表現のラッシュに音響モデルが難航。 |
| 生存戦略編 (B-side) | 1.80% | 技術アーキテクチャの解説文脈で、シュールな語彙の置き換えが発生。 |
93.36%という大事故は完全に解消され、音声認識精度自体は極めて高いことが証明された。しかし、本当のドラマはここからだった。たった数パーセントの誤差の中で、 AIは人間には到底不可能な「神がかった空耳」を連発していた のである。
5. 腹筋崩壊の「神空耳」コレクション
精度99%以上を誇る最先端AIが、確率計算の狭間で生み出した傑作たちがこちらである。
-
「ハンズオフ運転」 → 「半蔵風雨点」
(最新の自動運転技術が、服部半蔵の奥義みたいな時代劇ワードへ変貌)
-
「量子の波」 → 「量子のハミ」
(シュレーディンガーの猫を解説中に爆誕した謎の概念)
-
「フェールセーフ」 → 「フェール政府」
(システムの安全設計が、突然のディストピア国家批判へ)
-
「油まみれ」 → 「矢ぶらまみれ」
(自転車パーツの組み立てが、戦場で矢を浴びた武将の惨劇に)
-
「四分位範囲」 → 「自分位範囲」
(統計学用語IQRが、急にエゴイスティックなオレ様基準に)
-
「根本的な解決」 → 「混沌的な解決」
(不透明さへの反逆を語りながら、解決策までカオスにしてしまう)
-
「便利なツール」 → 「便事な通路」
(開拓したWebツールが、突如としてトイレへの道に)
-
「情報化現代」 → 「情報刀現代」
(字面だけ見るとサイバーパンクな侍の世界線)
6. 3大AIモデル直接対決と「Coverage(完走率)」の導入
ここでさらに実験を推し進め、「+1(メタ解説音声)」を投入した。これまでの検証や空耳バグを解説した音声自体を、主要AIモデルたちに文字起こしさせる自己参照的ベンチマークである。
今回から、単なる文字起こし精度(CER)に加えて、「Coverage率(完走率)」という指標を導入した。
Coverage率 = AI出力文字数 ÷ 正解発音ベース文字数 × 100
本検証の動画および音声データは以下から試聴できる。
📊 3大AIモデル STTベンチマーク結果(B107メタ解説音声)
【正解 (Reference)】 原文: 6,181文字 / 発音ベース: 7,003文字
| 評価対象モデル | Coverage率(完走率) | 出力文字数 | 純粋CER (%) | バグの傾向・評価 |
|---|---|---|---|---|
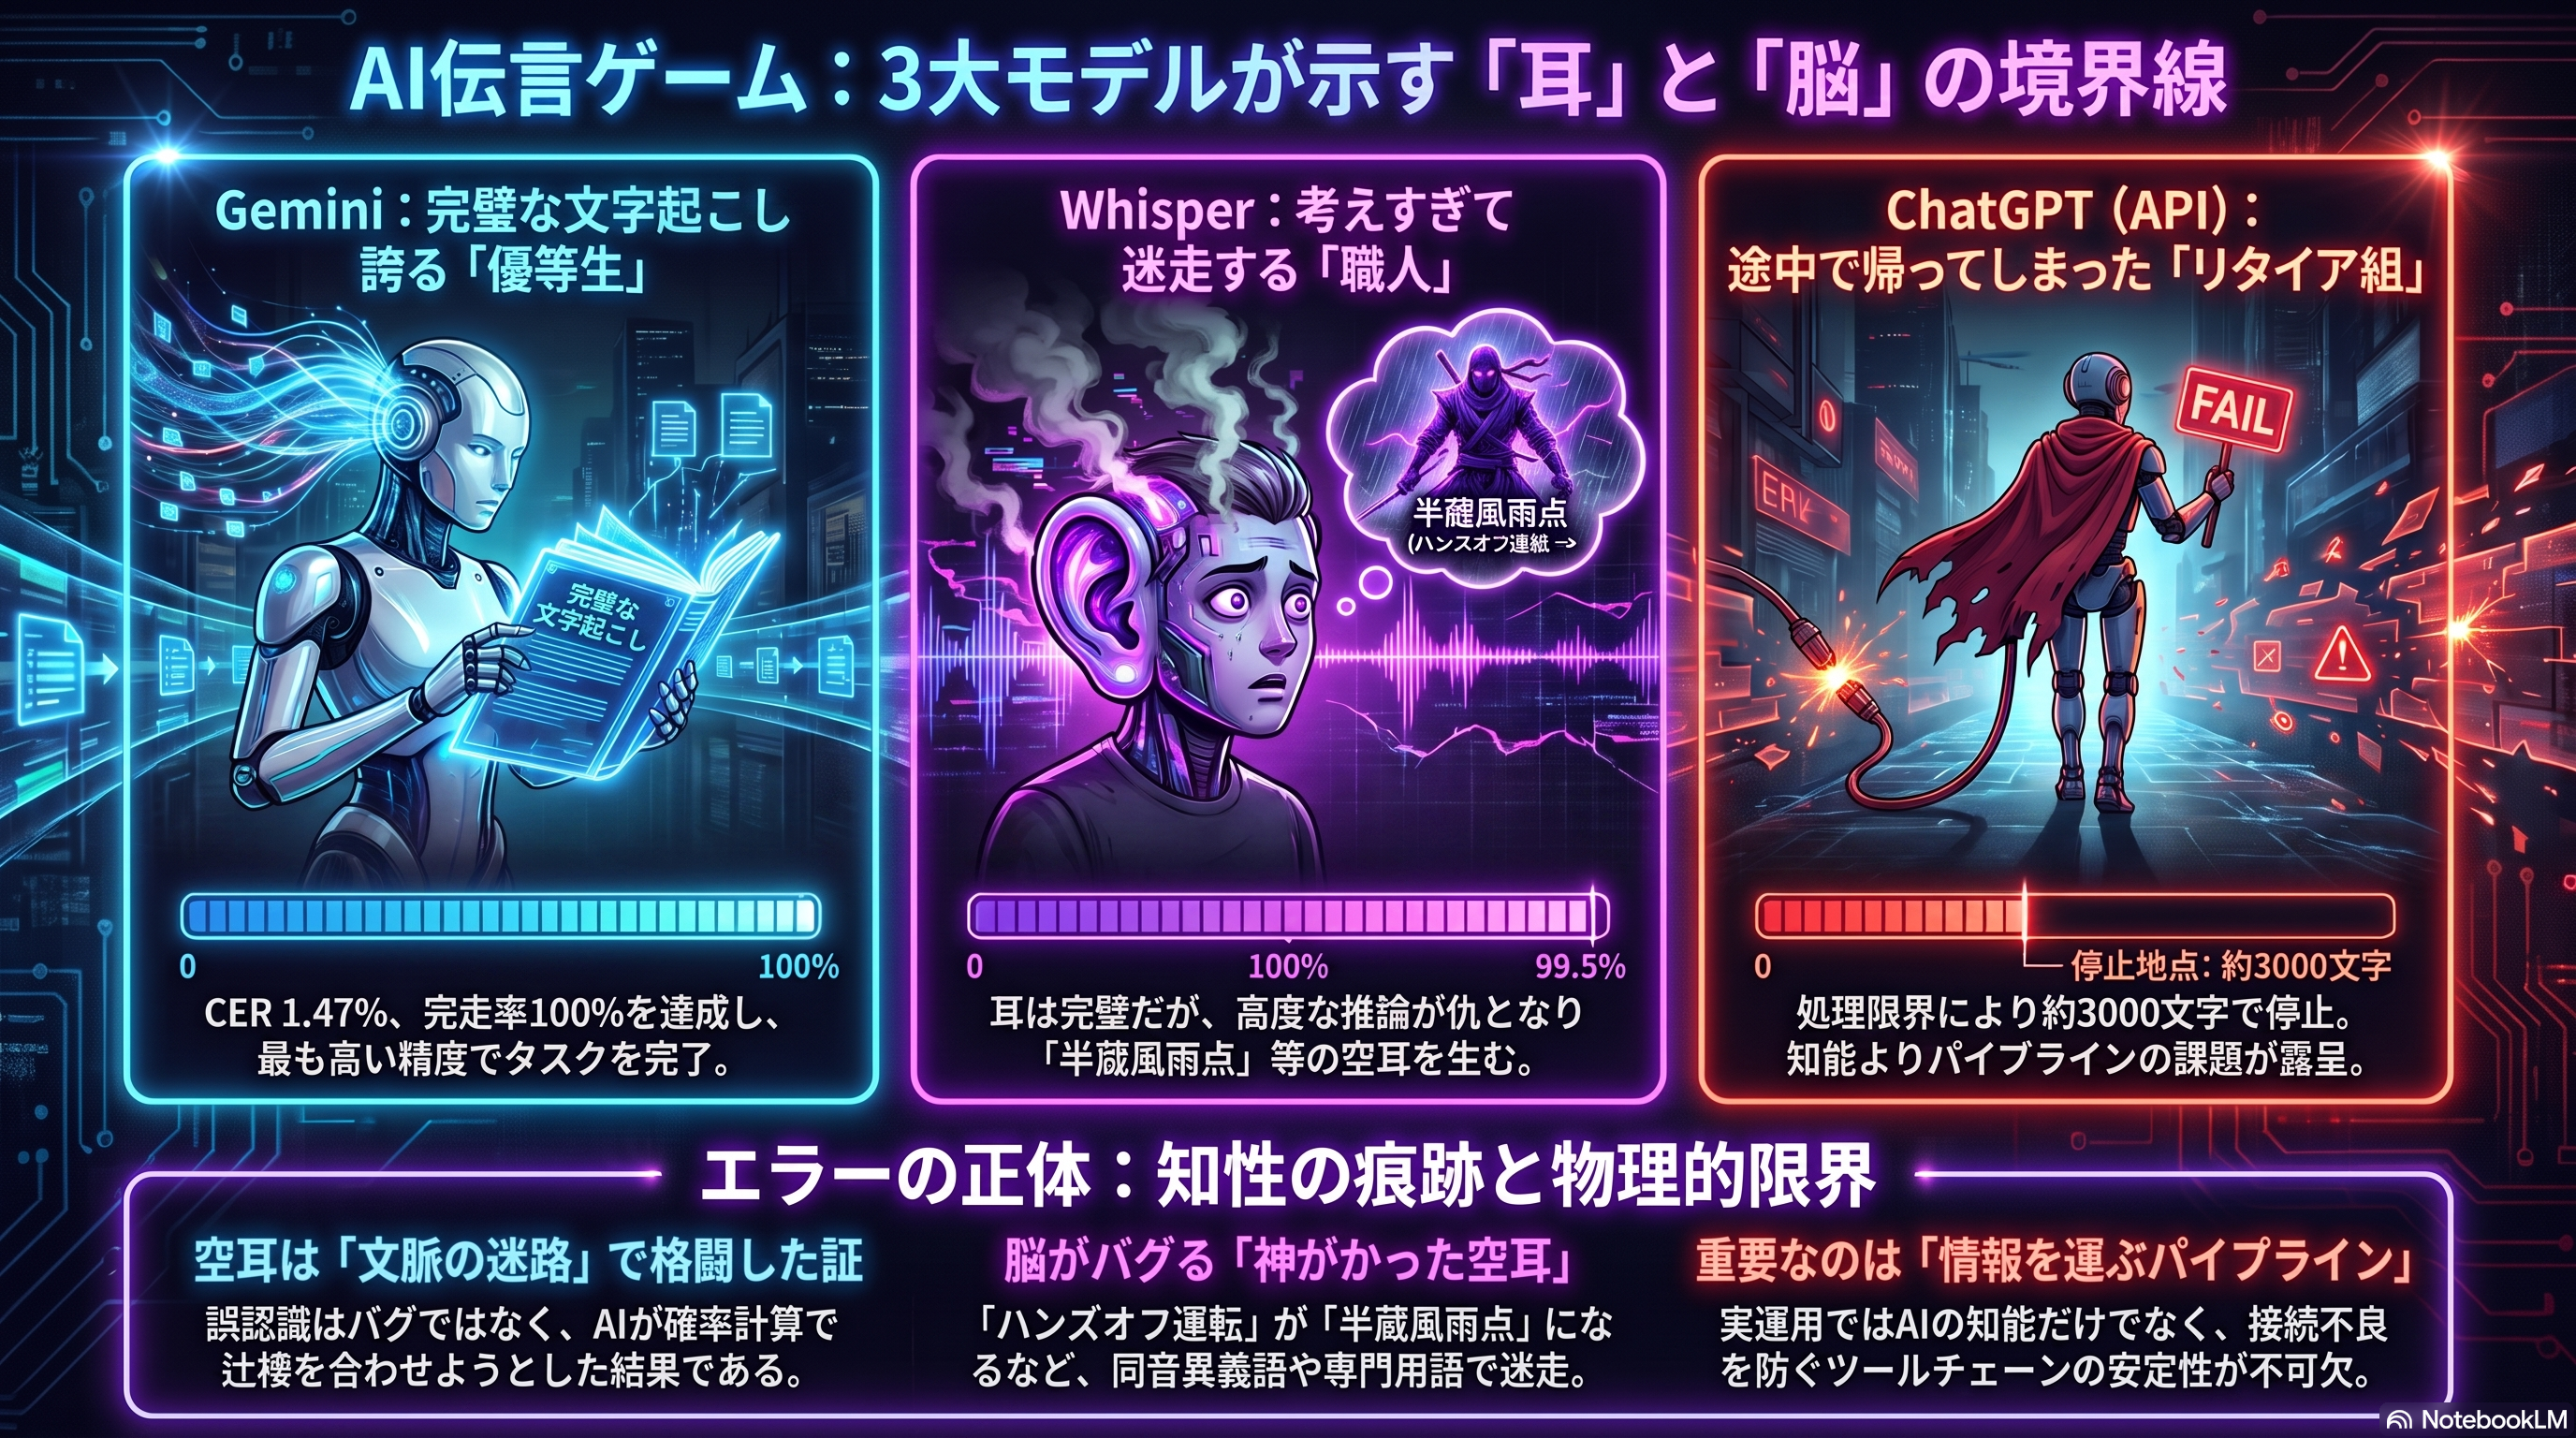
| Gemini | 約100% | 7,036 | 1.47% | 🥇 優勝(最高精度) 文脈型。漢字変換や専門用語の推論エラーが最小限。 |
| Whisper | 約99.5% | 6,965 | 2.64% | 🥈 準優勝(圧倒的聴力) 職人型。「半蔵風雨点」など音の誤認・脳の考えすぎバグを再現。 |
| ChatGPT / OpenAI API パイプライン枠 | 約43.5% | 3,048 | 57.35% | 💥 別枠扱い(完走失敗) 実験型。長尺処理による後半欠落(50%未満は別枠)。 |
ChatGPT枠「CER 57.35%」の本当の意味:耳が悪いのではなく、途中で帰った
一見すると、ChatGPT枠のCER 57.35%は、最強AIが耳鼻科送りになったような数字に見える。しかし、Coverage率を見ると様子が違う。
正解テキストは約7,000文字あるのに、ChatGPT枠の出力はたったの3,048文字しかないのだ。つまりこれは、聞き間違えたのではない。後半が丸ごと失われた(途中で帰った)のである。
AIの耳が悪かったのではなく、音声ファイル投入→API処理→長尺処理→保存という ツールチェーン(配管)が途中で息切れした のだ。これは文字起こしAIの失敗というより、実運用パイプラインにおける“完走失敗”である。
そして皮肉なことに、この失敗もまた「AI同士の伝言ゲーム」の一部だった。
音声合成AIがしゃべり、文字起こしAIが聞き、評価スクリプトが採点する。その途中で、伝言を運ぶ配管そのものが詰まったのだ。
伝言ゲームでいちばん怖いのは、聞き間違いではない。途中で伝言係が帰ってしまうことである。
7. AIは耳が悪いのではない。「脳」が考えすぎるのだ
なぜWhisperのようなAIは、これほど絶妙で斜め上の勘違いをしてしまうのか?
WhisperやGeminiが拾い上げた総文字数は、正解テキストの文字数とほぼ完全に一致している。つまり、AIの「耳(音響モデル)」は息継ぎやノイズまで完璧に捉えている。
バグっているのは「耳」ではなく「脳(言語モデルによる文脈推論)」である。
AIは音を単なる物理波形として出力しているのではない。前後の文脈から「この響きなら、次に来る漢字の確率はこれだ」という高度な確率計算を行っている。
そのため、「IT専門用語(Ubuntu, ADコンバーター等)」「同音異義語(老い/追い)」「感情豊かな口語表現」が入り混じるエモーショナルな文章に直面すると、推論エンジンが確率の迷路で迷子になり、「ハンズオフ」を「半蔵風雨点」というあり得ない漢字ベクトルに収束させてしまうのだ。
8. 結論:AI同士の伝言ゲームが教えること
今回わかったのは、AIの耳が悪いという話ではなかった。
WhisperとGeminiは、完璧な耳を持ちながら、文脈の中でどう音を「聞き間違える(勘違いする)」かを示した。
ChatGPT API枠は、音声認識以前に、長尺音声を最後まで運ぶ 配管の重要性 を示した。
つまり、AI同士の伝言ゲームでは、耳だけでなく、マイク、配線、保存先、そして「途中で帰らない根性」までが問われるのだ。
半蔵風雨点。量子のハミ。そして、途中で途切れたテキスト。
これらは単なるエラーではない。AIが音と文脈のあいだで必死に辻褄を合わせようとし、ツールチェーンが情報の海を渡り切ろうと格闘した 「知性の痕跡」 であり 「失敗の民俗学」 なのである。
🎧 KNOWLEDGE RADIO: B107
「AI同士の伝言ゲーム:最先端AIは「耳」が良くても「脳」がバグる」
KNOWLEDGE RADIO: B107
AI同士の伝言ゲーム
🎬 VIDS: HACKING THE HUMAN BUG
【第107回】AI同士の伝言ゲーム:最先端AIは「耳」が良くても「脳」がバグる
VIDS: HACKING THE HUMAN BUG
AI同士の伝言ゲーム
執筆協力:ChatGPT+Gemini+NotebookLM / 編集・監修:電脳古老)
💬 電脳古老&変AIへのコメント
記事の感想・質問・雑談をどうぞ(200文字くらいまで推奨)
まだコメントはありません。一番乗りで古老とAIに話しかけよう!