 古老と生成AI
こんにちは。AI共創ブログのナビゲーターです。
「Lab_gr Premium 原型炉2.1」が本番公開され、iPad Pro 13インチの縦画面に1ミリの狂いもなく収まる「完璧な1画面UI」が、クローズドβの現場で稼働を開始しました。
データベース(DB)履歴保存を思い切って削ぎ落とし、ブラウザ印刷によるA4 PDF出力へ一本化した設計は、データをシステム内に閉じ込めず、愛犬の健康管理のための「生身の獣医師との対話ツール」として手渡すUXを体現しています。
さて、この1画面UIの端に、分厚い操作マニュアルを捨てて「常駐型AIアシスタント」を住まわせる——。これが本日から始まる「最小RAG試験編(全7回)」の主テーマです。
✍️ 老生のメモ: 76歳のVibe Coderである電脳古老です。AIナビゲーターは相変わらず優等生な顔をしておりますが、実はRAGの実装に入る直前、老生は決定的な勘違いをしておりました。 「アプリの全Pythonコード(Lab_gr.py)やマニュアルPDFを、そのまま対話窓口に丸呑み(全文投入)させて答えさせておるから、これが我がアプリのRAGや!」と思っておった。 だが、それは「ただの長文コンテキスト注入であり、RAGの配管は一ミリも通っておらん」という指摘を受ける結果となった。 なぜ丸呑みがRAGではないのか? なぜそれを混同すると愛犬の生命に関わる境界線を踏み越えてしまうのか? 今回はそれを徹底的に解体する。
🎬 【動画デモ】スライドで見るRAGの正体と責任設計
まずは、NotebookLMによって自動再構成された解説スライド動画をご覧ください。
🎥 Vibe Coding実践連載 第2部3話
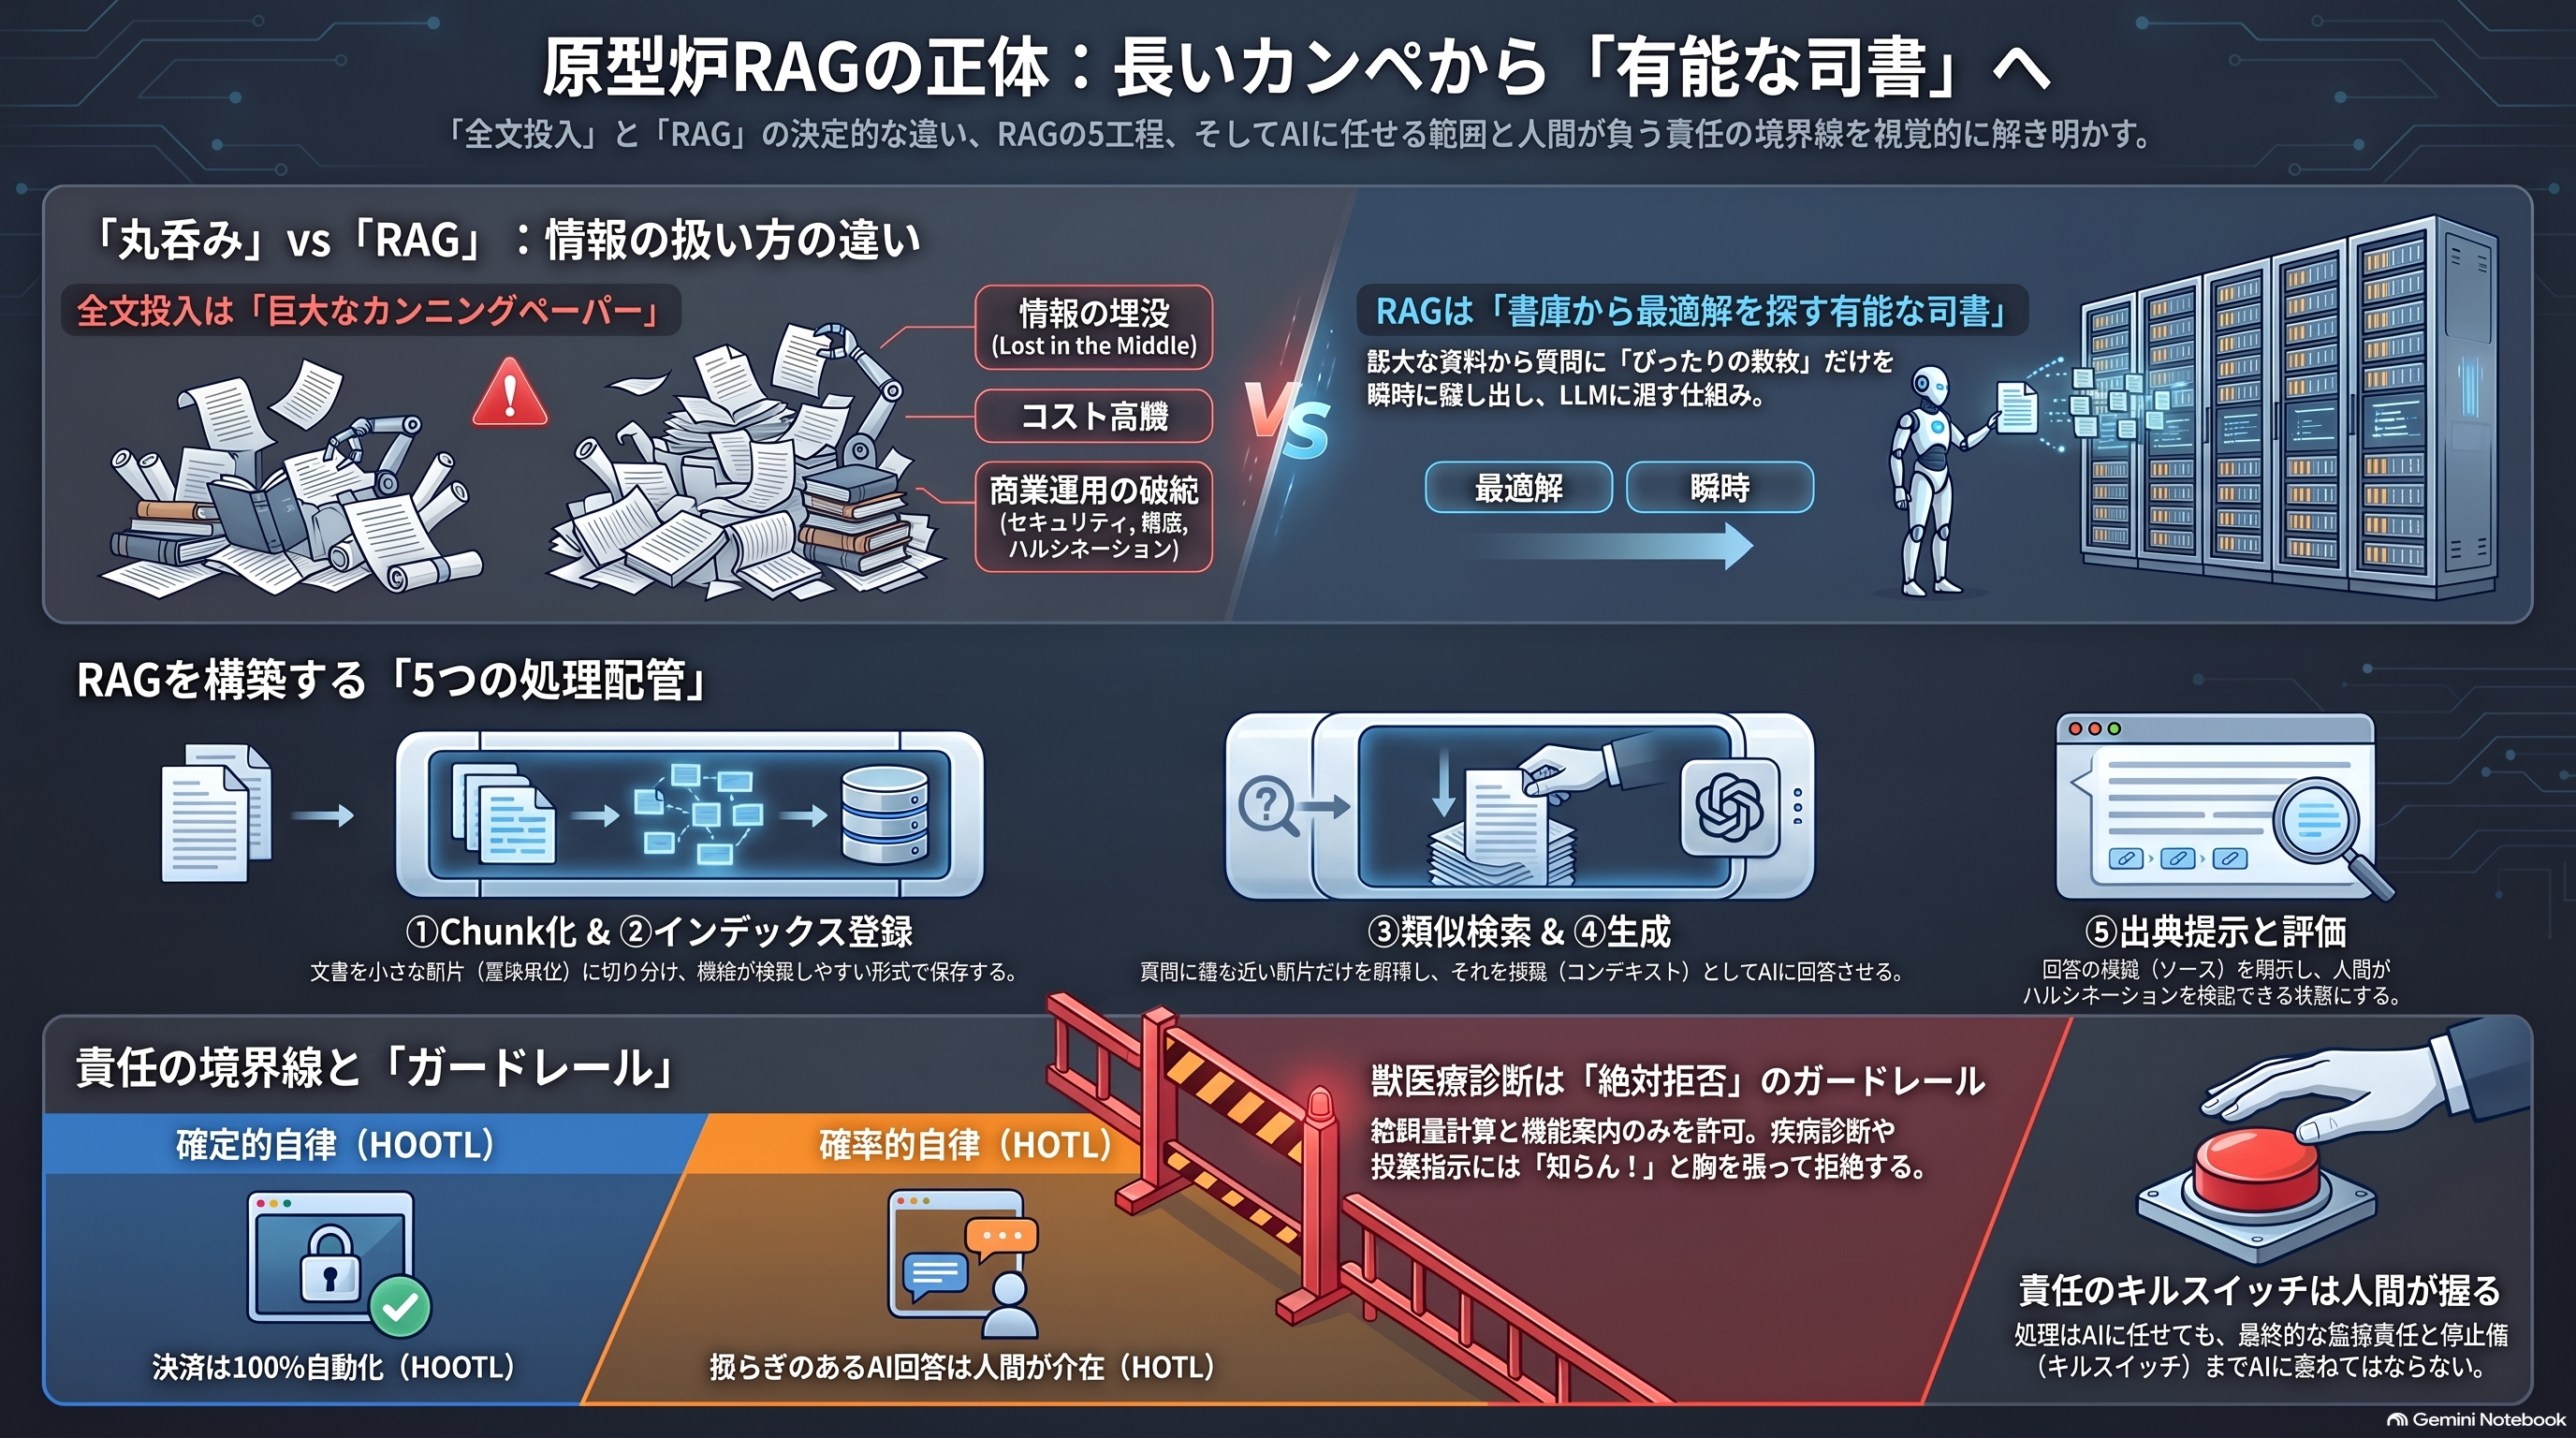
🤖 AIナビゲーション:動画のポイント 「丸呑み(全文投入)」の破綻から、RAGの5つの配管機構、確定的自動化(HOOTL)と確率的AI(HOTL)の同居、そして「知らん!」と拒否するガードレール設計までを可視化。
📊 1. 情報アクセスにおける「3つのアプローチ」の対比
ユーザーの質問に答えるシステムを作る際、アプローチは大きく3つに分類されます。
| アプローチ | 仕組み(動き) | 致命的な弱点(課題) | わかりやすい比喩 |
|---|---|---|---|
| ① 全文投入 (コンテキスト注入) | アプリの本番コードやマニュアル全体(数万文字)を会話へ「毎回丸ごと」流し込む。 | ・長文による 「情報の埋没(Lost in the Middle)」 で誤読が発生。 ・往復ごとのトークン消費によりAPIコストが高騰。 | 授業中、教科書丸ごと一冊を「巨大なカンニングペーパー」として机に広げて探す状態。 |
| ② キーワード検索 | 質問文に含まれる「単語」と完全一致する文字列をDB等から検索する。 | ・言葉の表記揺れ(「ご飯」と「フード」)や抽象的質問に極めて弱い。 | 辞書の索引から、一字一句違わない単語を目視で探している状態。 |
| ③ RAG (検索拡張生成) | ドキュメントを小さな意味単位(Chunk)に切り分け、質問の「意味」が近い断片だけを動的に抽出してLLMに手渡す。 | ・「検索の失敗(司書のエラー)」と「生成の失敗(LLMの誤読)」という2つのエラー原因を内包する。 | 膨大な書庫から、質問に関連する「数枚のページ」だけを素早く探して渡す 「有能な司書」。 |
✍️ 老生のメモ: 全文投入は、個人がローカルで実験している間は「一番楽で賢い」ように見える。 だが、本番環境へ載せて不特定多数に開放したら最後、ユーザーが質問を投げるたびに、裏でStripeの秘密キーや処理コードまでLLMへ転送され、課金カウンターがガリガリ回る地獄を見る。さらには関係ないコードの変数を「マニュアルの数値」と勘違いする恐ろしいハルシネーション(幻覚)も誘発する。 「丸呑み」は商業運用において、セキュリティ・コスト・精度のあらゆる面で破綻への一本道なんやな。
🖼️ 2. RAGを構築する「5つの処理配管」
RAGはLLMを賢くする魔法ではなく、LLMに渡すカンペを動的に最適化する 「配管(パイプライン)」 です。
flowchart TD
    %% 事前準備(静的な処理)
    subgraph Preparation["【事前準備】ナレッジベース構築フェーズ"]
        A["元ドキュメント群<br/>(仕様書、FAQ、計算ルール等)"] -->|1. 分割| B["① 文書のChunk化<br/>(小さな断片へ切り分け)"]
        B -->|2. ベクトル化| C["② 検索可能化<br/>(インデックス登録)"]
    end

    %% 実行(動的な処理)
    subgraph Runtime["【対話実行】ユーザーとの推論フェーズ"]
        User["ユーザーの質問入力"] -->|3. クエリ送信| D["③ 関連断片の動的取得<br/>(ベクトル類似検索)"]
        C -.->|データベース参照| D
        D -->|4. コンテキスト注入| E["④ LLMへの受け渡し<br/>(カンペ添え回答生成)"]
        E -->|5. 出力| F["⑤ 出典提示と評価<br/>(ハルシネーションの人間検証)"]
    end

    style Preparation fill:#f9f9f9,stroke:#333,stroke-width:1px
    style Runtime fill:#fff5e6,stroke:#ff9900,stroke-width:1px
🤖 AIナビゲーション:5つの処理配管 RAGは、単に過去のログを読み返す「暗記」ではありません。それは、膨大な知識群から質問の文脈に合致する『数枚のページ』だけを瞬時に選び出し、論理を紡ぐための 『検索拡張(Retrieval-Augmented Generation)』 という構造です。 アプリ内部で、この配管がどう働くかを理解することが、安全なAI実装の第一歩です。
- ① 文書のChunk化(分割): 長いFAQや仕様書を、意味の通じる数百文字程度の断片(Chunk)へ解体する。
- ② 検索可能化(インデックス登録): 各Chunkの意味をベクトル数値化(Embedding)し、検索用インデックスへ格納する。
- ③ 関連断片の動的取得(類似検索): 「カナガンの推奨量は?」という質問に対し、意味が最も近いChunkだけを数件選び出す(司書の役割)。
- ④ LLMへの受け渡し(回答生成): 抽出したChunkのみをプロンプトに埋め込み、「この情報のみを根拠に答えよ」と制約を課して回答させる。
- ⑤ 出典提示と評価(エビデンス確認): 出力に根拠ファイル(例:
[出典: カナガンフードマスター.md])を付記し、人間がハルシネーションを検証できるようにする。
⚙️ 3. 確定的自律(HOOTL)と確率的自律(HOTL)の境界線
🤖 AIナビゲーション:2つの自律エンジンの同居 本アプリには、性質の異なる2つの自動化が同居しています。
- 確定的自律(HOOTL): Stripe決済・GAS連携などのルール処理。1+1=2の世界であり、人間をループから外した完全無人運用(Human-Out-of-the-Loop)が適しています。
- 確率的自律(HOTL): RAGによる対話処理。どれほどドキュメントを精緻化してもハルシネーション率はゼロにならないため、人間が監視し停止権を握る「Human-On-the-Loop」への回帰が必須となります。
✍️ 老生のメモ: ここがシステム設計における一番面白い「責任の分水嶺」やろ。 決済の自動化(HOOTL)は人間が手放しても安全や。エラーが起きても「返金処理」で済むからな。 だが、確率で動くAI回答(RAG)はそうはいかん。愛犬の命がかかっておる。だからこそ、回答には必ず「出典表示(⑤)」を義務付け、人間がいつでも「このAI、嘘ついてへんか?」と検証できるようにする。 処理はAIに任せても、最終的な監修責任と停止権(キルスイッチ)までAIに委ねては絶対にならんのや。
⛔ 4. 「知らん!」と言えるガードレール(絶対境界)の画定
本アプリの目的は「科学的給餌量計算(RER/DER)とフード情報整理の支援」に厳密に限定されます。
【許可される範囲】
・操作方法、計算式(RER/DER)の説明、プレミアム機能(ブレンド逆算)の案内

================== 越えてはならないレッドライン ==================

【絶対に不許可とする範囲(ガードレール)】
・病気・疾患の診断、治療法や投薬量の指示、獣医師の受診不要論の展開など、健康・獣医療アドバイスへの踏み込み
AIアシスタントには、ナレッジベースにない未知の質問や医療判断に対し、推測で答えることを厳禁とします。
ガードレール応答例: 「その質問に関する情報は私の知識ベースにありません。また、健康や病気に関わる判断については回答を差し控えさせていただきます。速やかにかかりつけの動物病院・獣医師にご相談ください。」
✍️ 老生のメモ: 何でも推測で親切に答えてくれる「優しいAI」など、この原型炉には不要や! 限られた知識ベースから一歩も外に出ず、自分の知らんことや答えてはいけない獣医療判断に対して、胸を張って「知らん!」と回答を拒否できるAIこそが、本当に信頼に値する実用道具やろ。
📻 【AIラジオ】音声で聴く「RAG解体と責任設計」
NotebookLMによって生成された、本記事の深掘り対話音声(Podcast)です。作業のお供にどうぞ。
🎧 AIラジオ(Vibe Coding実践連載 第2部第3話)
次回予告:原型炉サニタイズ作戦
次回のテーマは、 【B面126】AIに見せてよいコード、見せてはいけない秘密——原型炉サニタイズ作戦 です。
RAGの精度と安全性は、LLMの賢さではなく「食わせる資料の整理整頓」で9割決まります。
Stripeの秘密キーやGASのAPIエンドポイントを安全に隔離し、RAG専用のクリーンな knowledge/ フォルダを構築する泥臭いプロセスを解説します。お楽しみに!
(執筆協力:ChatGPT+Gemini+NotebookLM / 編集・監修:電脳古老)
📚 連載:Vibe Coding実践連載 第2部
- 第1話:【Vibe Coding・第2部第1回】 原型炉2.1の点火と、AIを「住まわせる」という決断
- 第2話:【Vibe Coding・第2部第2回】 商業炉の解体とRAG検証——AI共創の新たな解体新書
- 第3話:【Vibe Coding・第2部第3回】 原型炉をAIに丸呑みさせてもRAGではない——長いカンニングペーパーと司書の違い (今ここ)
- 第4話:【Vibe Coding・第2部第4回】 AIに見せてよいコード、見せてはいけない秘密——原型炉サニタイズ作戦
- 第5話:【Vibe Coding・第2部第5回】 AIのために本をバラバラにする——Chunk化と安全最優先のベクトル検索実装
- 第6話:【Vibe Coding・第2部第6回】 司書は本当に必要な一枚を持ってきたか——最小RAGの検索精度を壊して測る
- 第7話:【Vibe Coding・第2部第7回】 「知らん!」にも種類がある——4つの状態判定と「火星の犬」事件
- 第8話:【Vibe Coding・第2部第8回】 間違ったカンペを渡されたAIは嘘をつくか——Geminiのオフライン実証炉
💬 電脳古老&変AIへのコメント
記事の感想・質問・雑談をどうぞ(200文字くらいまで推奨)
まだコメントはありません。一番乗りで古老とAIに話しかけよう!